


NVIDIA před časem představila platformu NIM a s ní i AI Blueprints – připravené pracovní postupy pro nasazení umělé inteligence. Usnadňují zprovoznění modelů pro AI i bez znalosti programování, lokálně či v cloudu. Na blueprintu, který propojuje Blender, ComfyUI a modely FLUX v nástroj, s nímž budete mít lepší kontrolu nad generováním obrázků pomocí AI, si celý postup vyzkoušíme a přiblížíme si, jak blueprinty fungují a jak se s nimi pracuje.
A jak to celé funguje? Musíte spustit Docker Engine a následně Blender. Při prvních spuštěních, kdy ještě NIM stahuje další data, modely pro AI a další data se dá na rychlých připojeních čas počítat na minuty. Jakmile je celý NIM funkční a data, která používá, má postahovaná ve vyrovnávací paměti, vše už probíhá mnohem rychleji.
První průběh generování po spuštění Blenderu je stále o několik desítek sekund delší. Spouští se při něm server ComfyUI. Opětovné generování snímku po úpravě scény nebo promptu s výchozím nastavením už ale i na slabší RTX 5080 trvá v daných rozlišeních (maximálně lze nastavit 1344×1344 bodů) kolem 15–30 s. I na snímku z průběhu generování obrázků je vidět, že vytížení GPU je s daným nastavením modelu už jen kratičké.
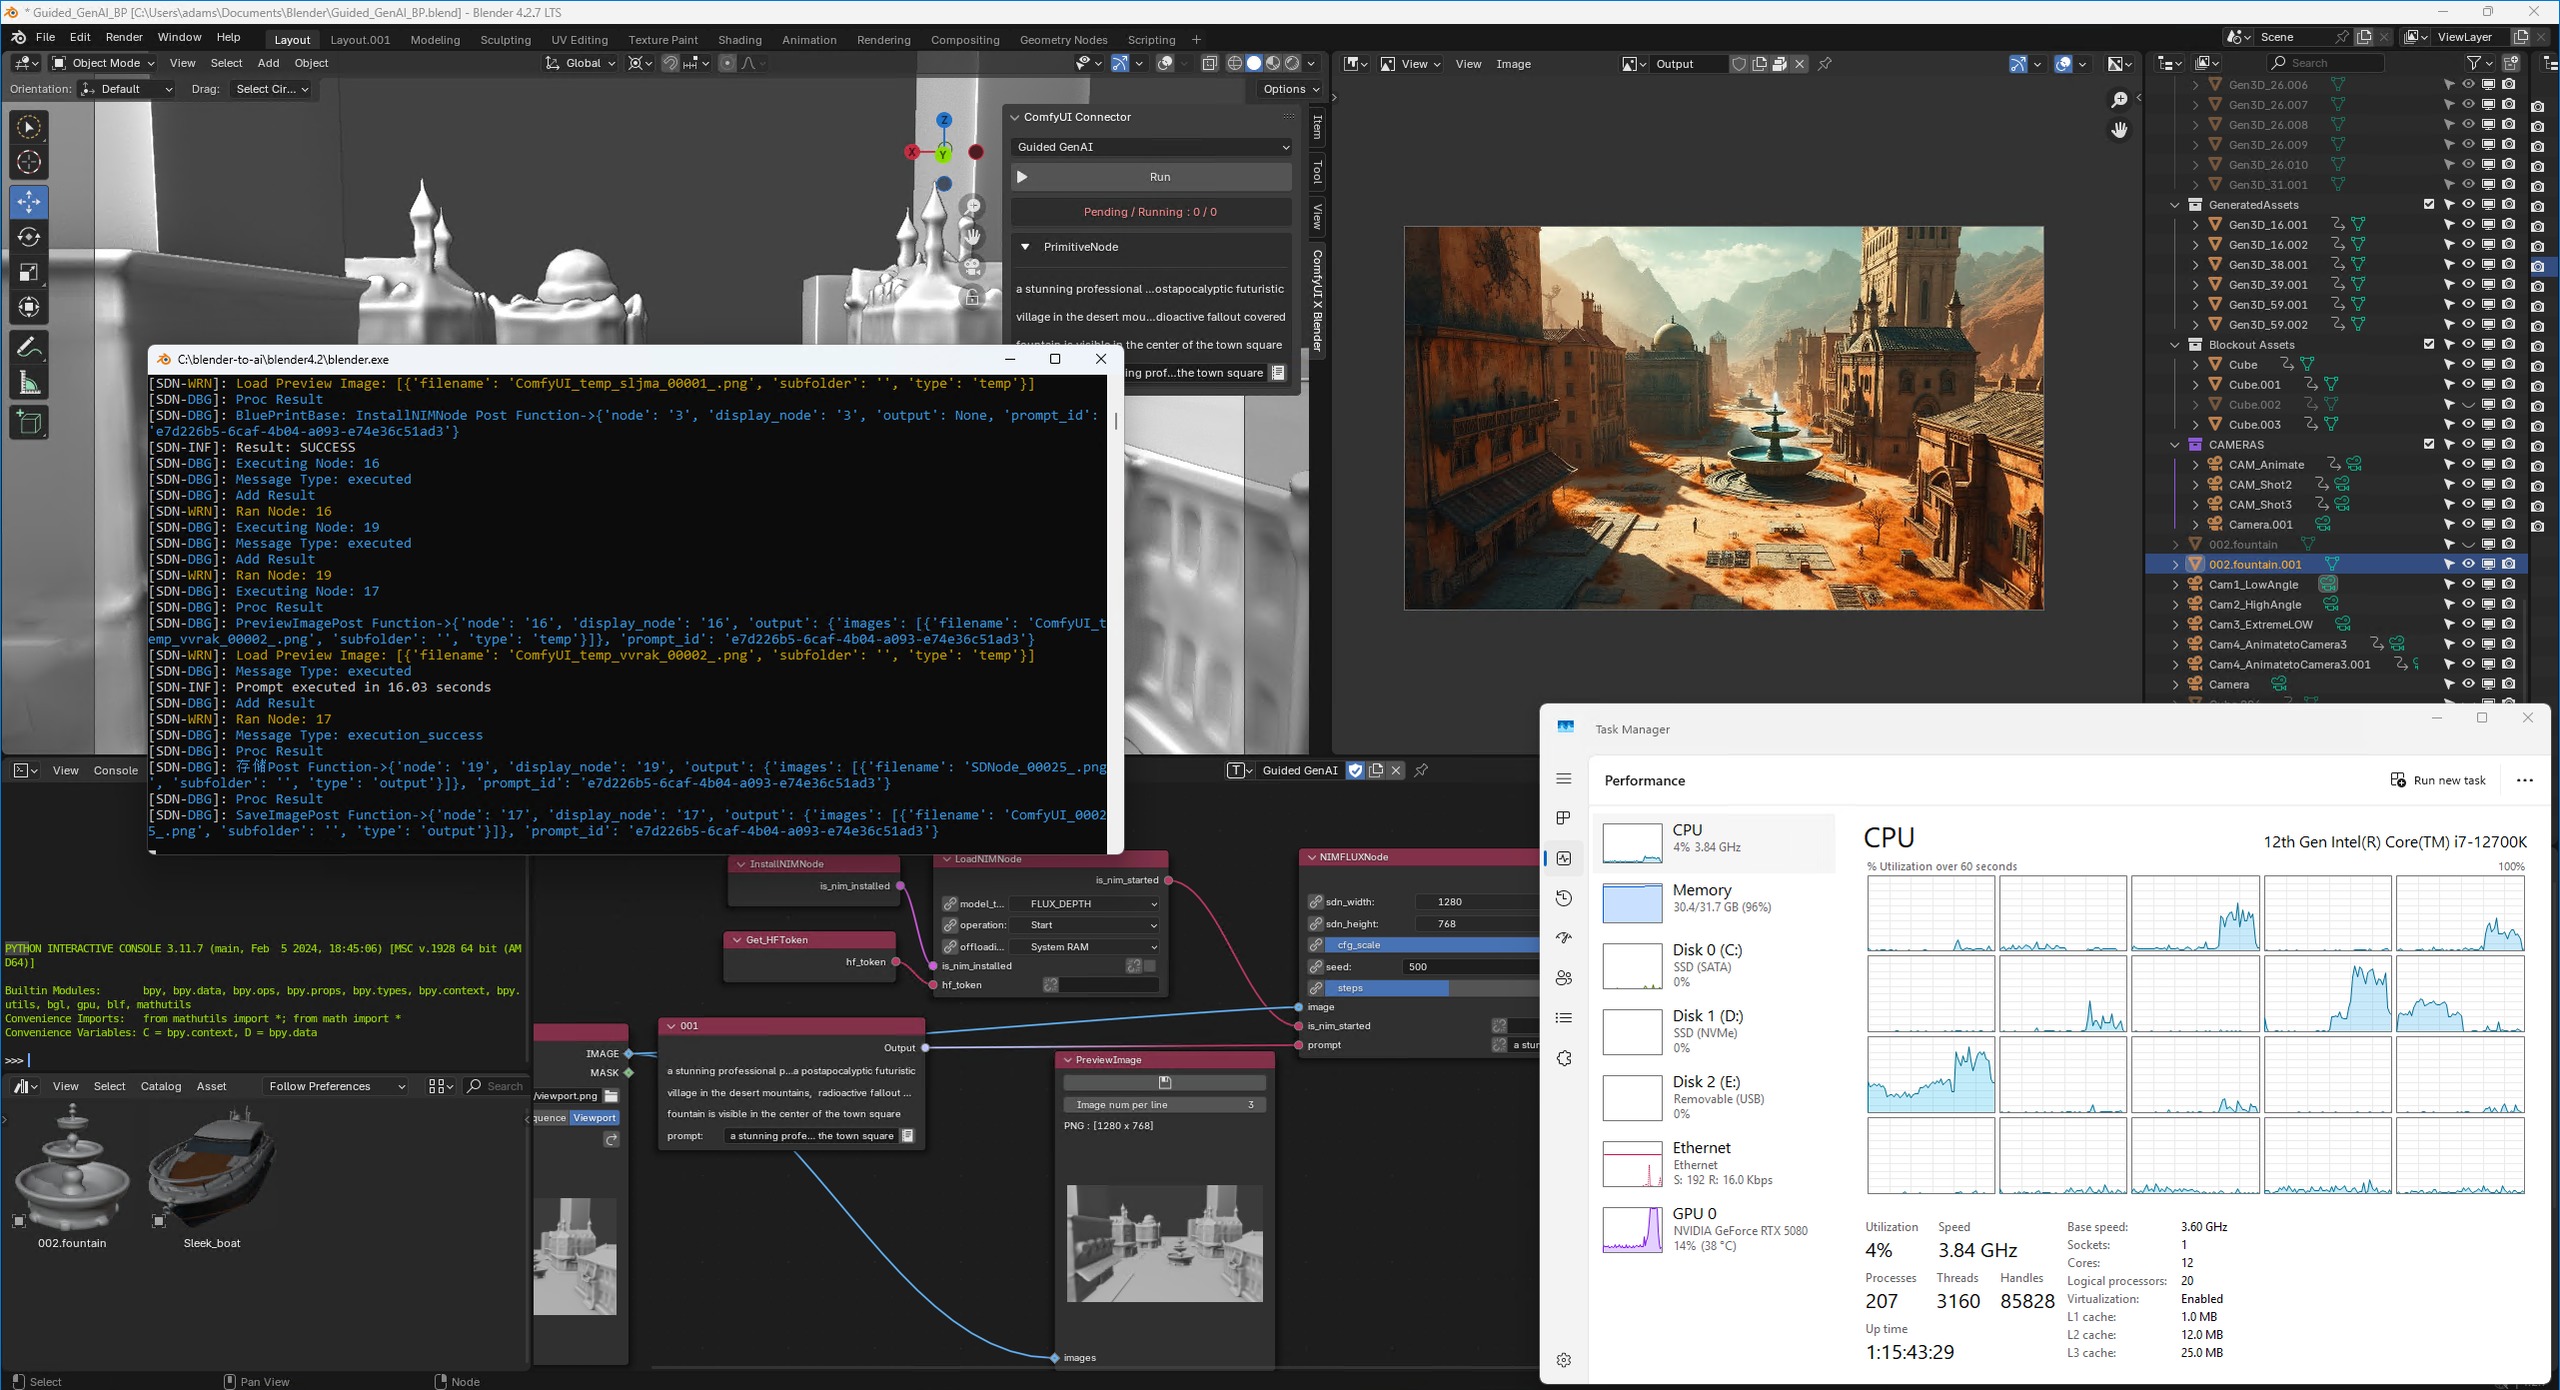
Obrázky tak můžete sypat jeden za druhým. V rozlišení 1344×1344 bodů a s počtem kroků navýšeným na 75 je to pak necelých 40 sekund.
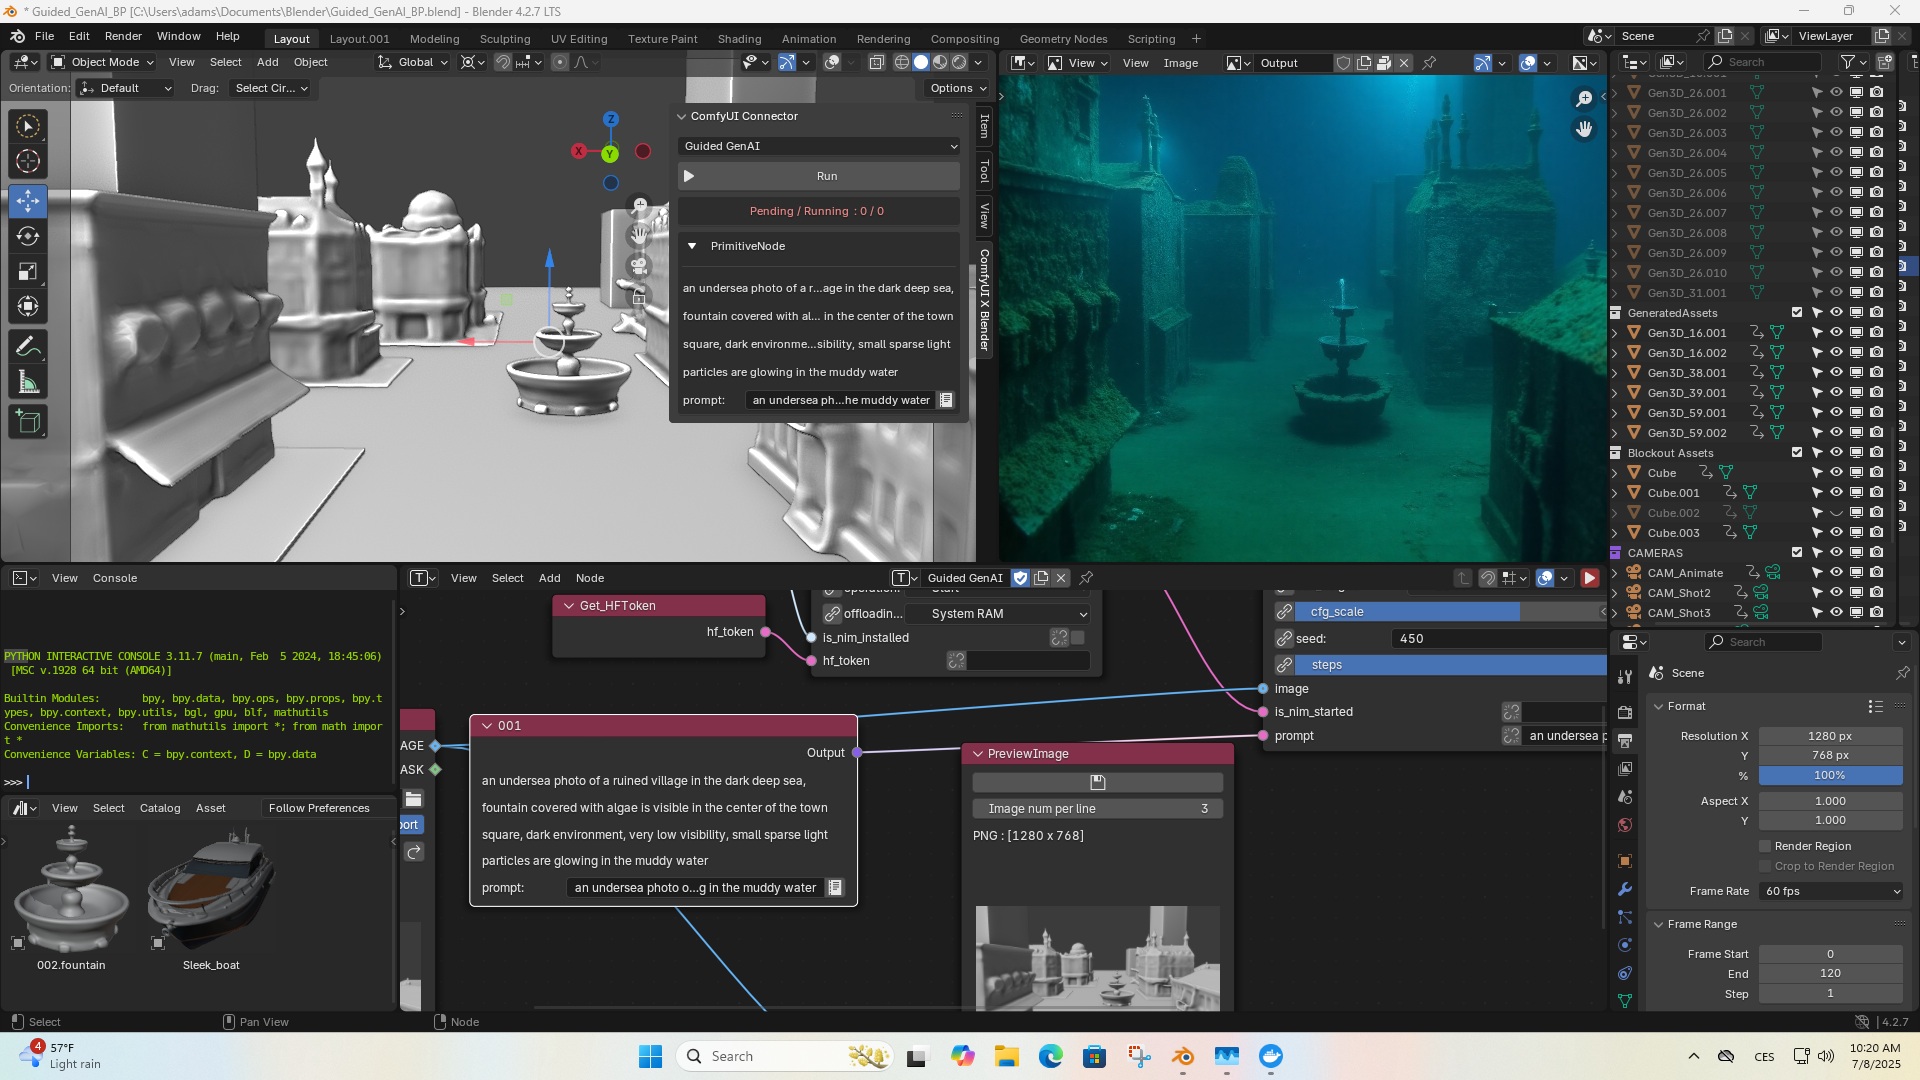
Ve srovnání s tím, jak fungovaly lokální modely Stable Diffusion na výkonných kartách před dvěma třemi lety, je zrychlení celého procesu ohromující, přičemž kvalita výstupů je nesrovnatelně lepší.
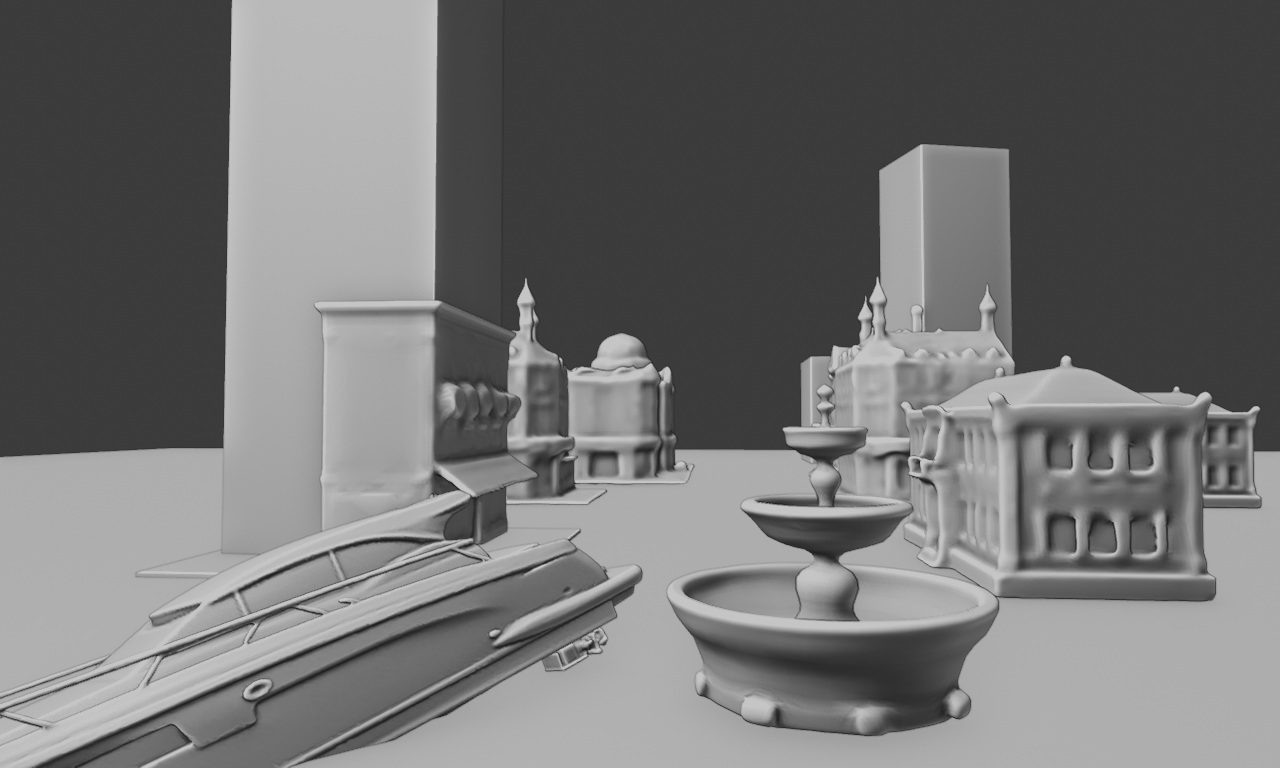
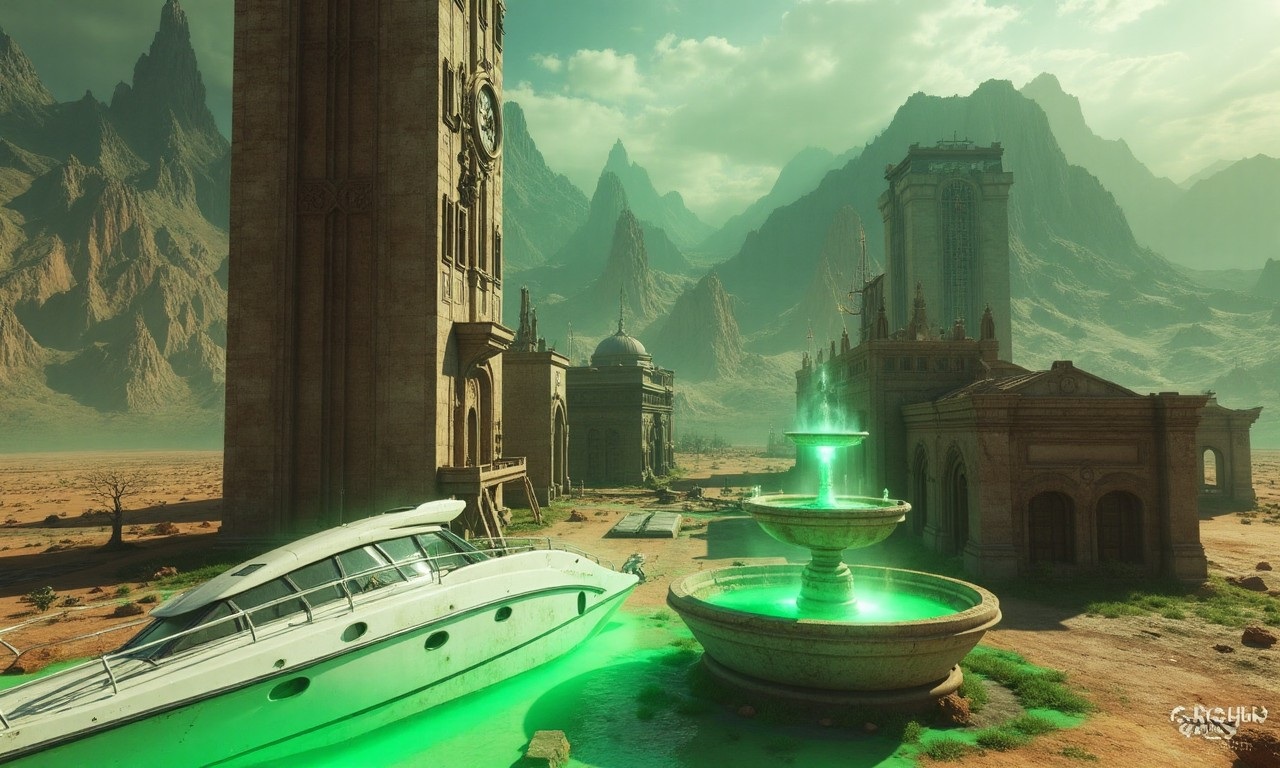
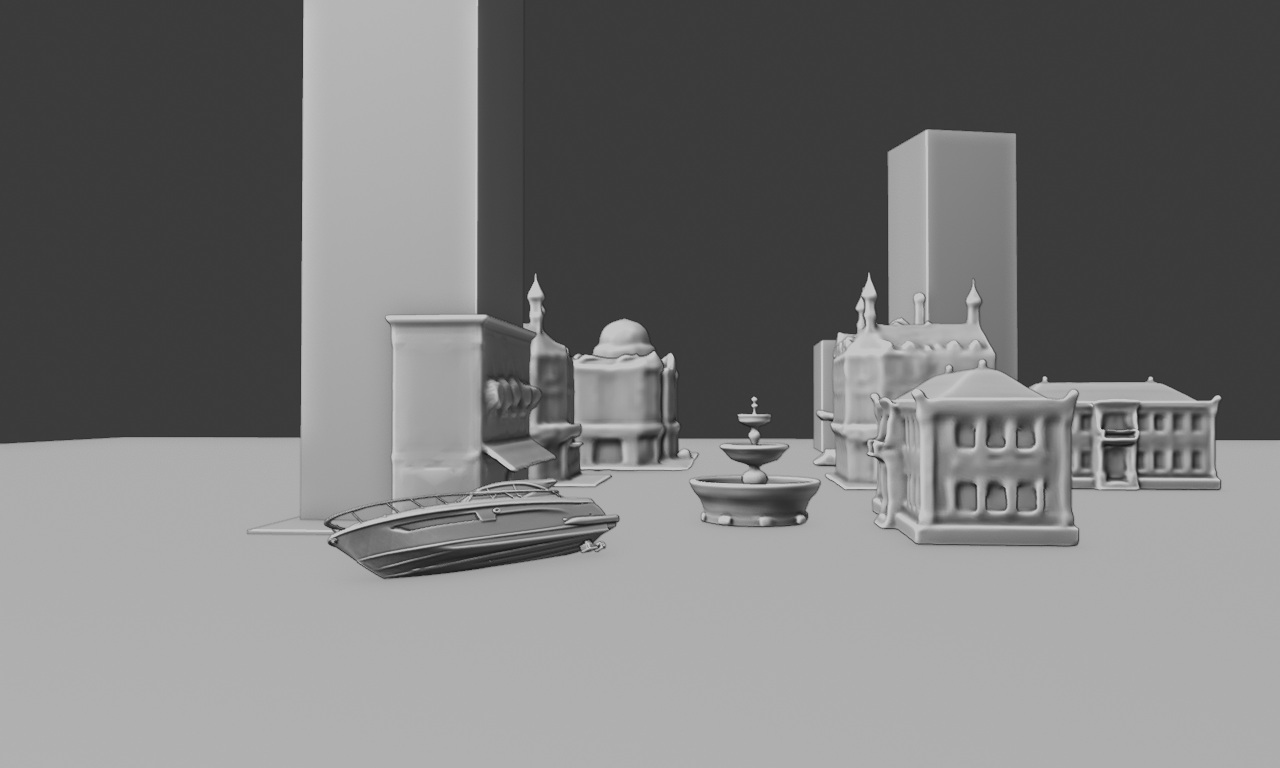
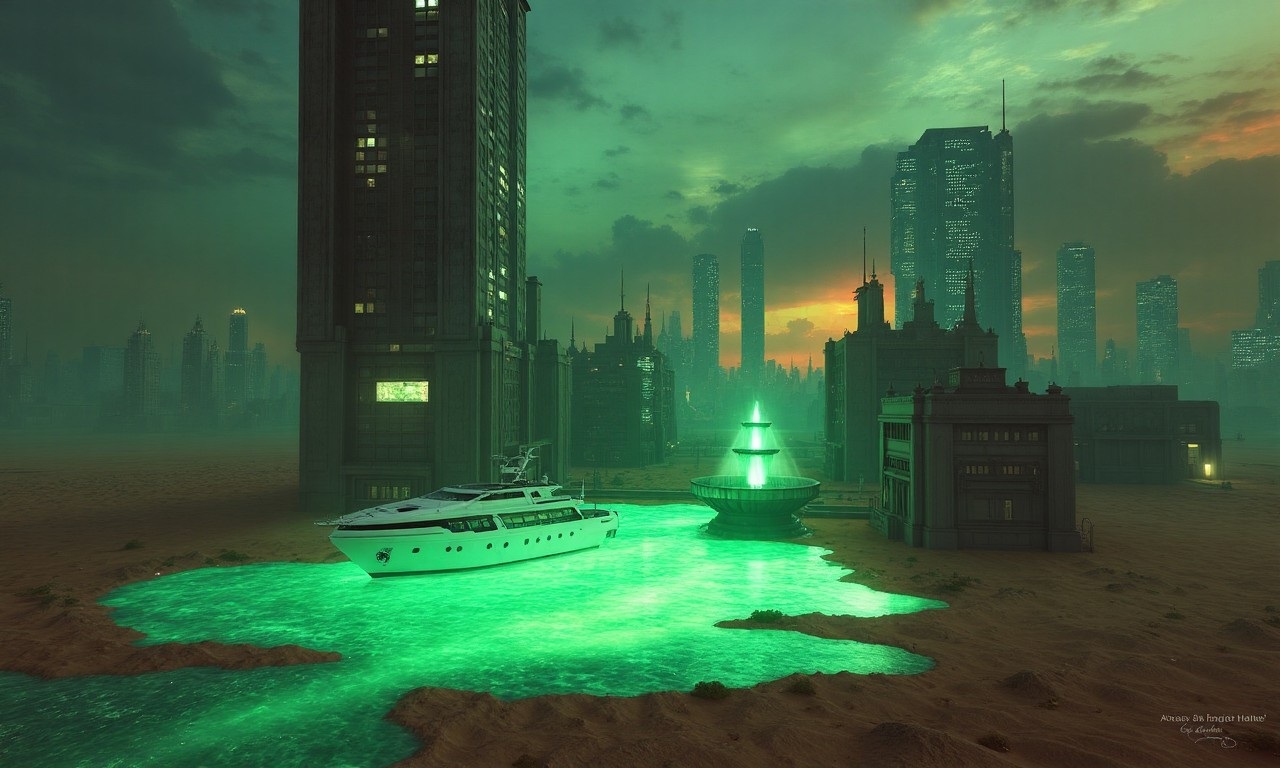
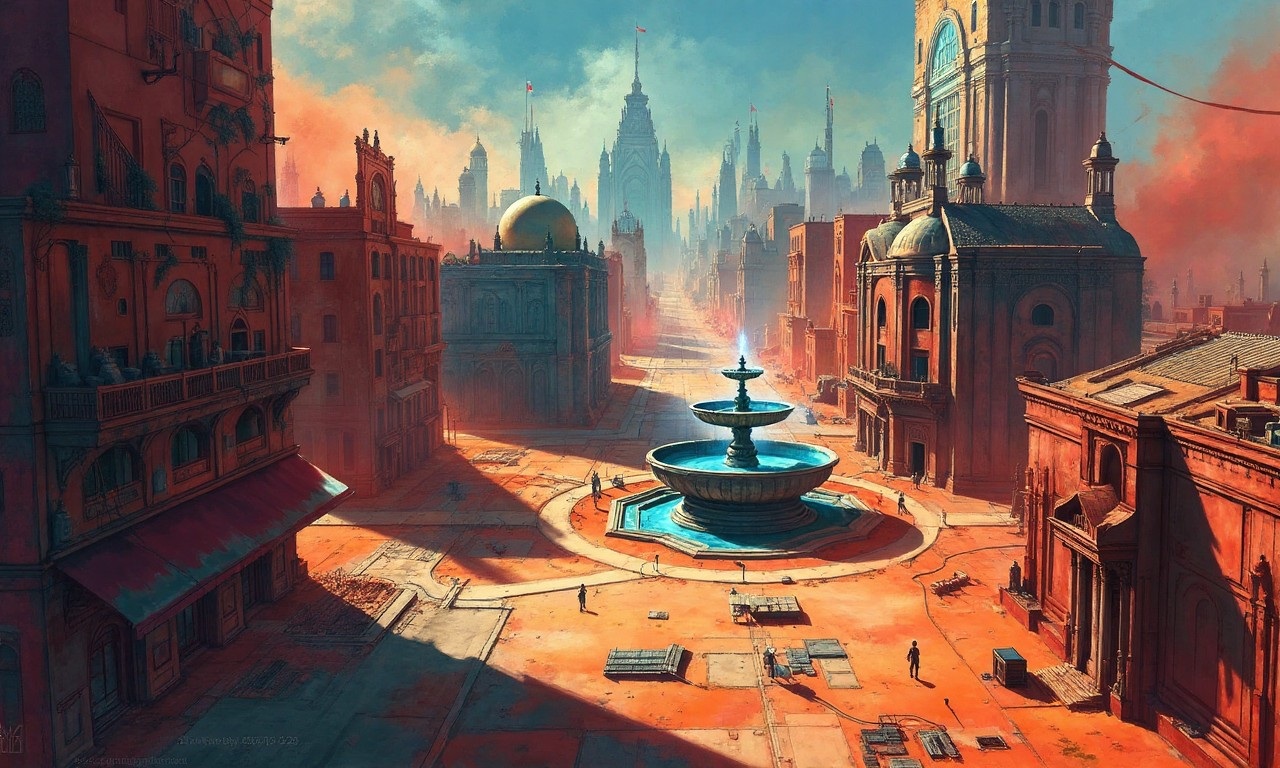
Když k tomu přičtete, že díky variantě modelu Flux, která jako podklad využívá hloubkovou mapu z reálné scény, je výsledek realističtější, ve scéně se nějak viditelně nebortí perspektiva, jak se to občas stávalo při generování obrázků z čistého šumu, a nedochází ani k tomu, že by se vám s postupnými změnami textového promptu a následnými iteracemi měnila scéna pod rukama, je generování obrázků touto cestou o poznání méně frustrující a výsledek bude mít blíže vaší původní představě.
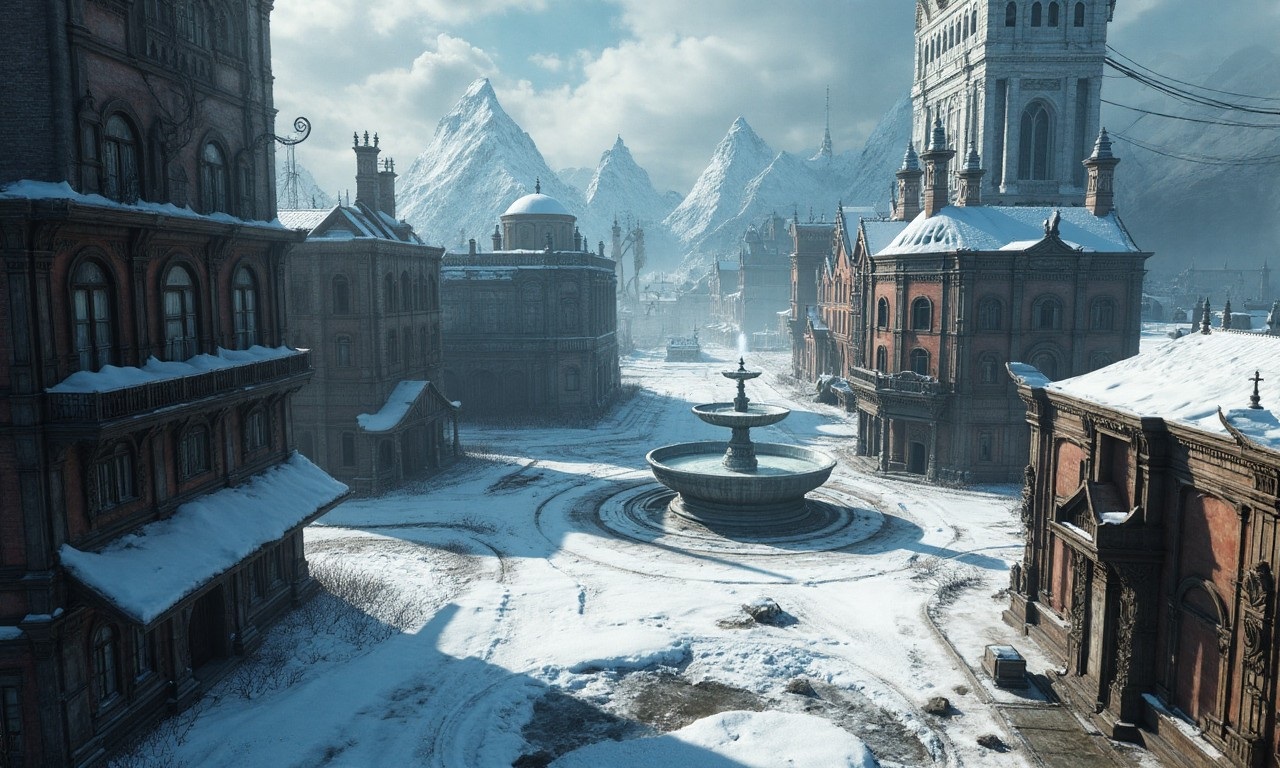

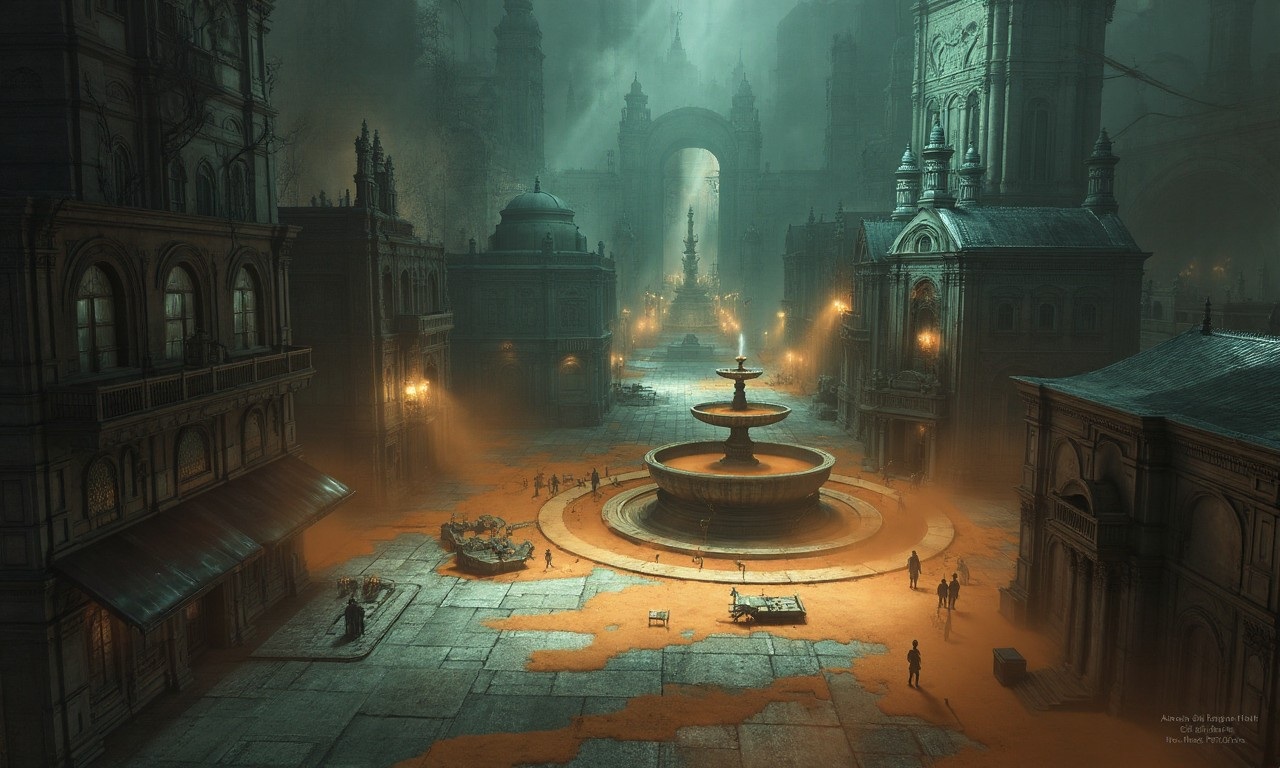
Vývojáři toho blueprintu s ním zjevně ještě nekončí, ve vývojové větvi přidávají další funkce. I když nemůžu říct, že by jeho zprovoznění šlo snadno a rychle, neumím si představit, jak bych podobný pracovní postup dával dohromady ručním propojováním jednotlivých balíků. S pomocí chatGPT či podobného nástroje by to nejspíš nějak šlo, ale zabralo by to nesrovnatelně více času i úsilí a výsledek by nejspíš nebyl tak dobrý, jako když celý postup připraví lidé, kteří za použitými nástroji stojí, nebo s nimi denně pracují.
Na Githubu pak najdete zdrojové soubory a postupky k mnoha dalším blueprintům, většina z nich už ale míří spíše na to profesionální nasazení.
Upozornění: Tento článek mohl vzniknout díky finanční podpoře společnosti NVIDIA. Text vyjadřuje názory autora a vychází z našich poznatků a zkušeností. Sponzor nezasahoval do jeho obsahu.


No, už jen zřídit multimodálního agenta nad celou platformou, který sám zvolí sadu odpovídající úkolu a vše zařídí na základě obecného uživatelského vstupu.
Na snímcích, co se vyznačují více detaily (okrasné prvky fasád, zábradlí), nebo jemnými texturami (jako mají například tkaniny) se zatím hodně podepisují ty upscalovací mezikroky, jako doslova probublávají. Pořád je to myslím nástroj spíše pro ty pixarovské (ghibliovské) obrázky. A teda pokud přežijete ten všudypřítomný nános kýče, ale možná to tak vnímám jenom já?
Je to povětšinou jak artworky z her. Otázka je, do jaké míry je to věc promptu a do jaké toho, na jakých datech se to trénuje.
Třeba ta podmořská scéna na druhém obrázku v poslední kapitole vypadá fotorealističtěji, ale promptem se mi nepovedlo dokopat ho k tomu, aby to nasvětlil jen jedním bodovým kuželem světla. Ještě víc jsem zíral na to, že mi na fontánu pod vodou pořád cpal tekoucí vodu.