


Minulý měsíc AMD vydalo procesory Ryzeny 5000. Jejich architektura Zen 3 přinesla nakonec možná víc, než se čekalo, výkon na 1 MHz někde převyšuje i IPC nejnovějšího jádra Intelu Willow Cove (Tiger Lake). Zen 3 je podle AMD jeho největší překopání architektury od vůbec prvního Zenu, pročež se podíváme, jaké změny v něm inženýři provedli, aby dokázali porazit Intel i v jednovláknovém a herním výkonu.
Cache nezměněné – až na L3 a rozdělení bloků CCX
AMD nezměnilo mezipaměti cache. Zůstává 32KB L1 cache pro data s 8cestnou asociativitou a latencí zřejmě 4 cykly, L2 cache je také 512KB s 8cestnou asociativitou a latencí snad pořád 12 cyklů.
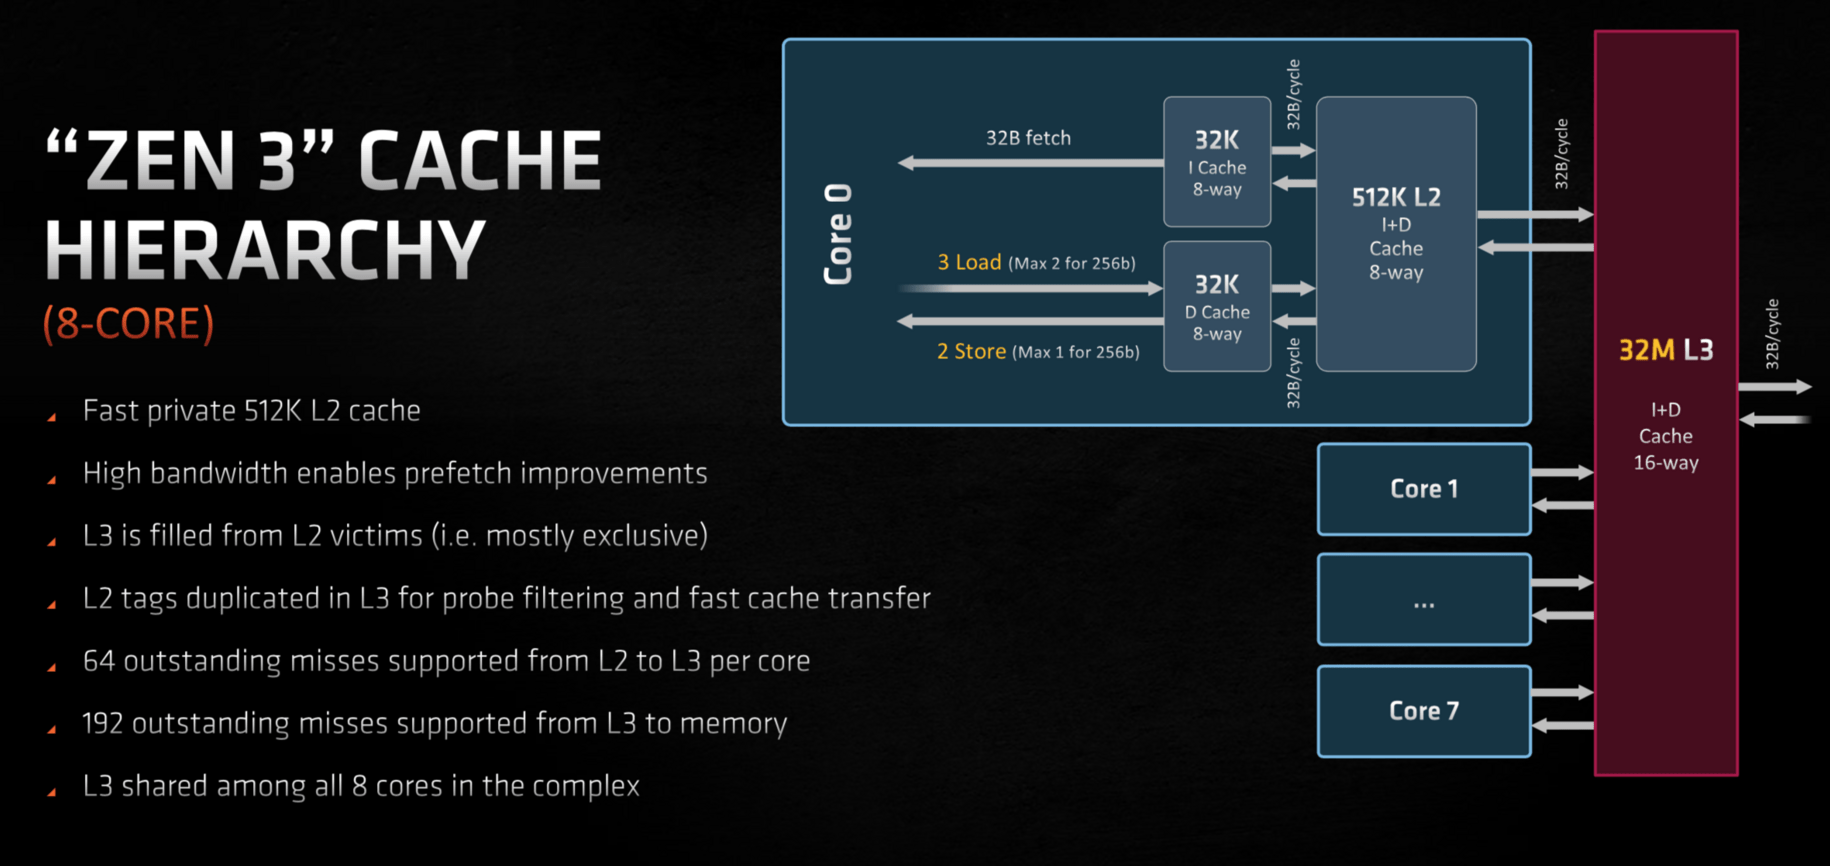
Kde je to ovšem jiné, je L3 cache. Souvisí to s jednou z mála zásadních změn, kterou Zen 3 provedl mimo samotná jádra. U Ryzenů 3000 a 4000 s jádry Zen 2 (a stejně tak u Zenu 1) byla jádra vždy spojena po čtyřech do tzv. CCX (Core Complex), v jehož rámci sdílela jeden blok L3 cache. V osmijádru proto musely být dva CCX každý s vlastní L3, které spolu komunikovaly jen pomocí propojovací logiky Infinity Fabric.
Zen 3 místo toho spojuje jádra do osmijádrových CCX, které celé sdílejí jeden blok L3 cache. U procesorů s počtem jader do osmi je latence komunikace výrazně lepší, protože odpadá přenos informací s druhým CCX. Procesory s více než osmi jádry potřebují použít více CPU čipletů, takže tam už se dopady na výkon opět projevují, ale díky osmijádrovým CCX by měly být zmírněné.
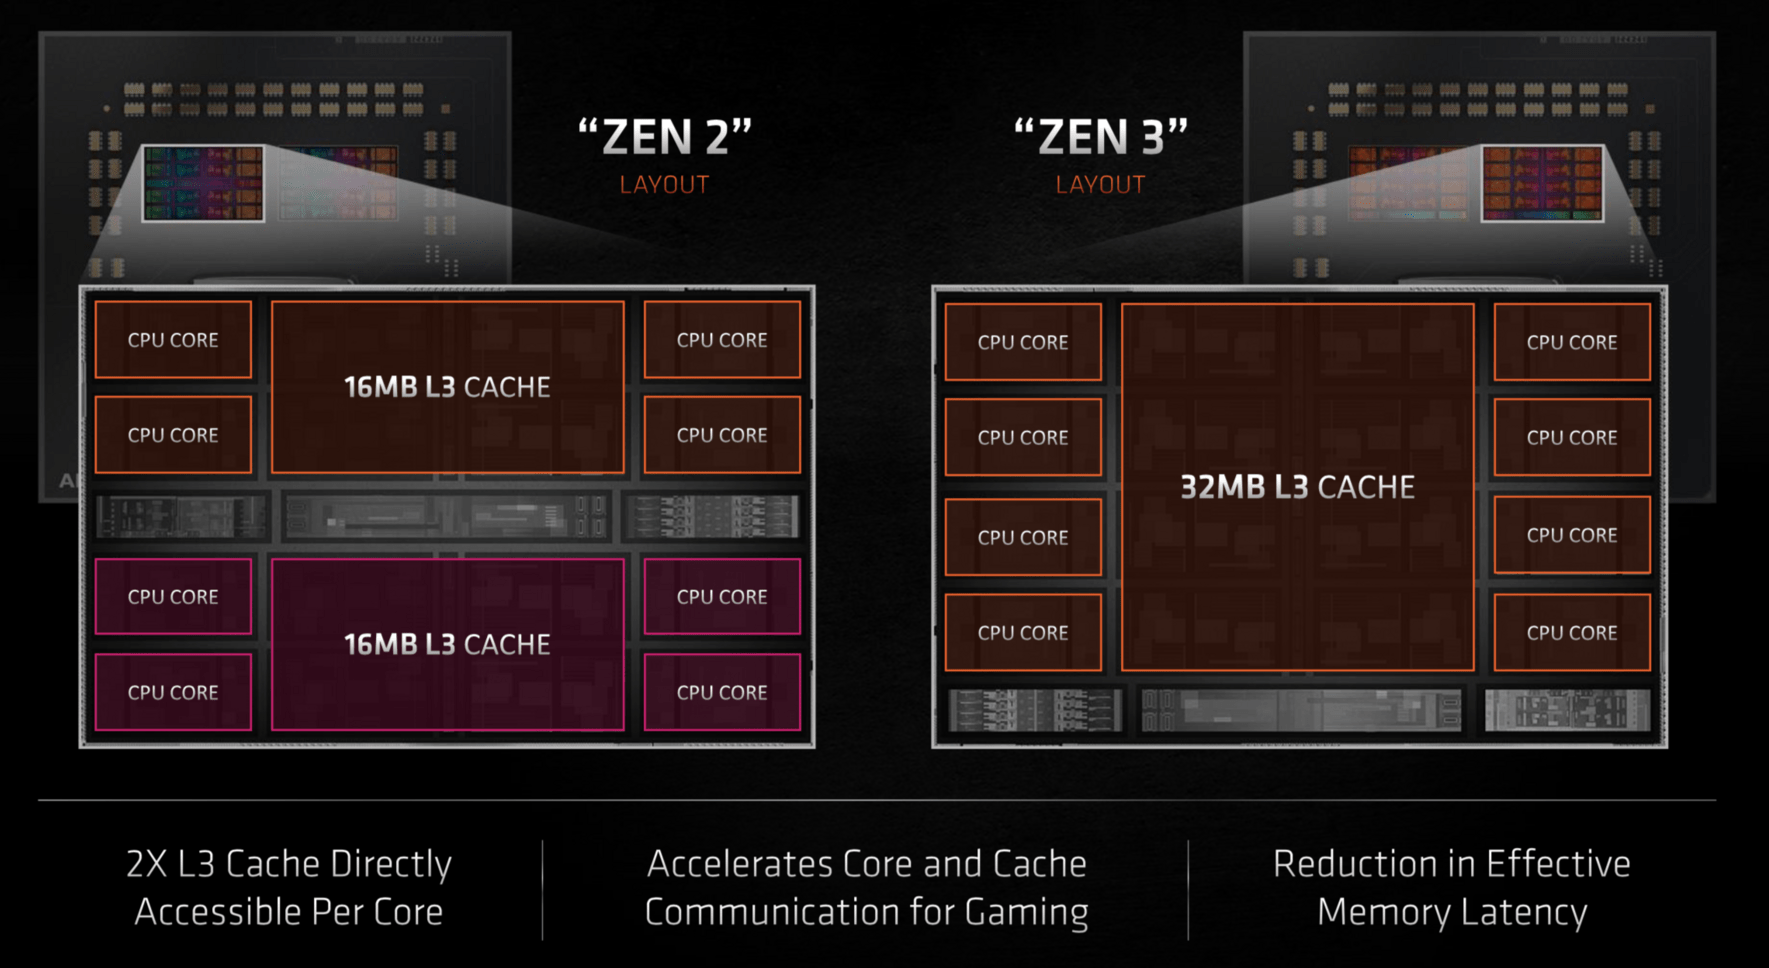
Zatímco Zen 1 měl bloky L3 cache o kapacitě 8 MB a Zen 2 o kapacitě 16 MB (pro ta čtyři jádra v CCX), Zen 3 spolu s dvojnásobným počtem jader v CCX také zvedl kapacitu jeho L3 na 32 MB, což je nyní přístupné všem osmi jádrům (je to tedy, jako by se dva předchozí CCX sloučily, včetně jejich cache). Toto zvyšuje výkon tím, že mimo omezení potřeby žádat data z jiných bloků CCX mají také jádra přístup k většímu ucelenému bloku cache. Pokud je totiž aktivní jediné jádro, může teoreticky použít až těch 32 MB místo 16 MB, takže se mohou v některých případech hodně omezit cache missy. V praxi to bude trošku složitější, zdá se, že kapacita TLB bufferů v jádře není dost velká pro maximální využití celé L3 cache (pokud program nepoužívá velké stránky). Nicméně když budou L3 aktivně používat čtyři nebo více jader, už by toto omezení nemělo platit. Uvidíme, zda se TLB zvětší v příštích generacích…
Velká 32MB L3 má i svá negativa. Zdvojnásobení kapacity způsobilo vyšší latenci. Ta se zhoršila o asi 7 cyklů na průměrných 46 cyklů (přesná hodnota se liší podle toho, do které slice z kterého jádra se přistupuje). Také se nezvýšila celková maximální propustnost, takže pokud by v osmijádrovém CCX všechna jádra například četla z cache, dosáhne každé jen poloviční propustnosti proti tomu, co je dosažitelné v čtyřjádrovém CCX v Zenu 2. AMD ale zvětšilo frontu pro požadavky na data z paměti při obsluze „cache miss“ z 96 na 192 položek, takže zde je kapacita fronty na jádro zachována.
L3 cache zůstává převážně exkluzivní, plní se daty, které vypadnou z L2 (a potažmo L1), takže jde o tzv. victim cache.
Mimochodem: zatím vydané procesory s jádry Zen 3 (Ryzeny 5000 „Vermeer“ pro socket AM4) mají 32MB cache, ale nemusí to platit vždy. Mobilní/APU Verze „Cezanne“ pro notebooky bude asi mít kapacitu odlišnou. U APU na bázi Zenu 1 (Raven Ridge, Picasso) a Zenu 2 (Renoir) AMD používalo jen 4MB L3 cache na jeden CCX. Podle úniků se zdá, že mobilní Zen 3 by na tom mohl být lépe a už by mohl mít 16MB L3 cache. Tedy poloviční proti Vermeeru, ale 4× větší (z pohledu jednoho jádra) než dříve. Ale tyto procesory zatím nebyly vydány ani oznámeny, takže zde ještě není jisto.
Paměťový řadič a IO čiplet převzaté z předchodzí generace
Za L3 cache už se dostáváme do stavu, kdy procesor čte nebo zapisuje do operační paměti. Její řadič je už ale v IO čipletu, který je použitý stejný, jako v procesorech Ryzen 3000. Výkon přístupu do paměti se tedy fyzicky příliš nezlepší, ovšem přesto mohou uživatelé pozorovat zlepšení reálného výkoná díky větší/lepší cache v CPU čipletu a lepšímu prefetchi plus třeba oněm page walkerům navíc.

Mělo by nadále platit, že komunikace s IO čipletem probíhá pomocí logiky Infinity Fabric, a to s datovou šířkou 16 bajtů za cyklus při zápisu a 32 bajtů za cyklus při čtení (propustnost pak závisí na frekvence IF, která je závislá na rychlosti, s jakou běží paměti DDR4). Čtení je tedy dvakrát rychlejší. Toto se může ukázat jako bottleneck v syntetických benchmarcích, kdy procesory s jedním CPU čipletem (6 a 8jádra) mají nižší maximální výkon v zápisu než dvoučipletové modely (12 a 16jádra). V praxi by to asi moc vadit nemělo.
⠀




Moc pekny clanek. Diky JO 🙂
Zdravím, taková otázka na autora. Můžem čekat více článků od tebe na tomto webu, vzhledem k situaci s cnews. Nebo jsou nějaké jiné plány?
klikni na autora auvidíš, koľko tu má článkov a budeš prekvapkaný, aký dlhý čas už!
Bez ohľadu na to, ako to dopadne so Cnews (verím, že pozitívne a čoskoro bude fungovať tak ako predtým), tak by Jano mal vo väčšom objeme vydávať články aj u nás. Celkovo sa na HWC čoskoro dočkáte veľkých zmien, na ktoré sa už pripravujeme dlhší čas a štart je blízko. 🙂
těšíme se… 🙂
číta sa to dobre, paráda, díkes 🙂
ešte tak prilákať Vítka a Rybku!